有道翻译网页翻译怎么用:页面识别、排版异常与结果复核
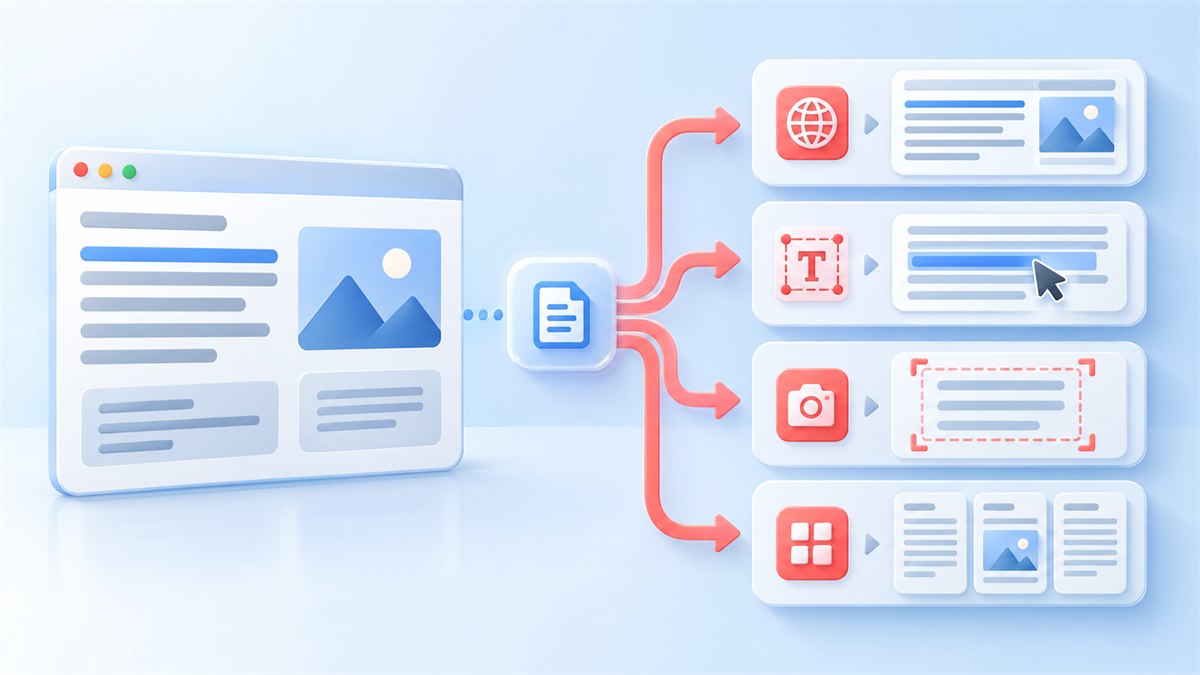
网页翻译的难点不只是把句子换成另一种语言,还要判断页面上哪些内容属于正文、哪些是导航或交互组件,以及翻译后有没有破坏原来的信息层级。遇到动态加载、图片文字、代码片段或复杂表格时,单次整页翻译可能无法覆盖全部内容。先识别页面类型,再选择整页、划词、截图或复制文本处理,通常比反复刷新更有效。
本文以日常阅读网页为场景,整理从翻译前准备、页面异常排查到重点内容复核的完整流程。不同系统、浏览器和客户端版本的入口可能不同,具体功能与支持范围请以当前界面为准。
一、先判断网页是否适合整页翻译新闻、帮助文档、博客和产品说明通常有连续正文,适合先尝试整页翻译。登录后的管理后台、在线表格、地图、聊天窗口和不断滚动加载的页面包含较多交互元素,翻译结果更容易缺段、错位或在操作后恢复原文。
开始前先完成需要的展开操作,例如打开折叠段落、切换到正确分页,并等待正文加载完成。若页面内容需要登录,请确认自己有权访问和处理其中的信息,不要为了翻译而把账号、验证码或不必要的个人资料复制到其他位置。
一个页面可能同时包含中文导航、英文正文、品牌名、代码和多语言评论。混合内容会增加语言判断难度。若自动识别结果明显不对,可手动选择源语言和目标语言,或只处理正文段落,避免让菜单、页脚和用户评论干扰判断。
专有名词、产品型号、缩写和人名不一定需要翻译。阅读前先标出必须保留的词,翻译后再逐项核对,可以减少把型号当成普通单词、把人名按字面翻译等问题。
三、页面排版异常时按问题类型处理翻译后出现按钮变宽、表格换行或段落重叠,通常是因为译文长度变化,而原页面容器没有足够空间。先尝试放大窗口、调整浏览器缩放或切换阅读模式;如果仍然影响阅读,可将重点段落复制到文本翻译区域,而不是继续在错位页面中寻找内容。
部分段落没有翻译时,先确认内容是否在嵌入框架、图片、画布或后加载区域中。可选择文字就用划词翻译;无法选择但清晰可见的文字,可改用截图识别;较长的可下载资料则更适合按文档处理。本站的常见问题也整理了网页翻译、截图和文档处理的区别。
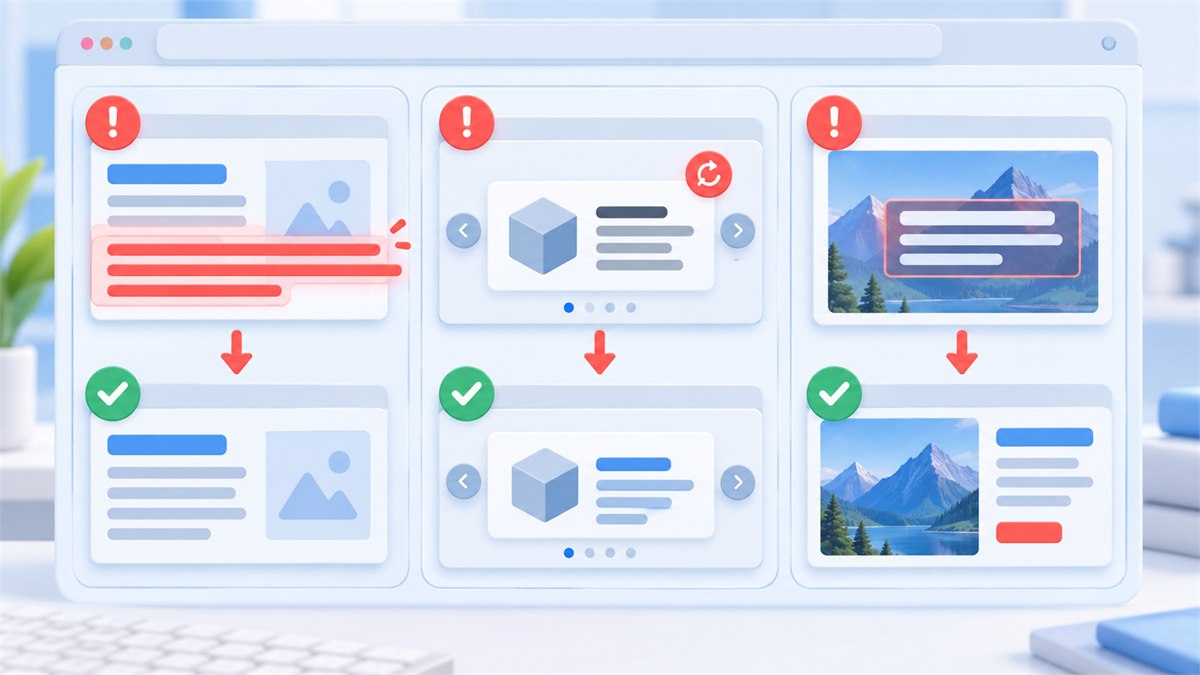
无限滚动列表、分页评论和点击后才显示的说明,可能在初次翻译后继续载入原文。每完成一次展开、翻页或筛选,都要重新检查新增区域。若页面频繁变化,可把需要理解的内容分成几个稳定区块逐段处理,并记录原文位置。
翻译过程中若必须点击链接,先确认它是否打开新页面,避免返回后丢失当前阅读位置。对需要引用的材料,建议同时保存标题、页面地址、访问日期和对应原文片段,不能只保留脱离上下文的译文。
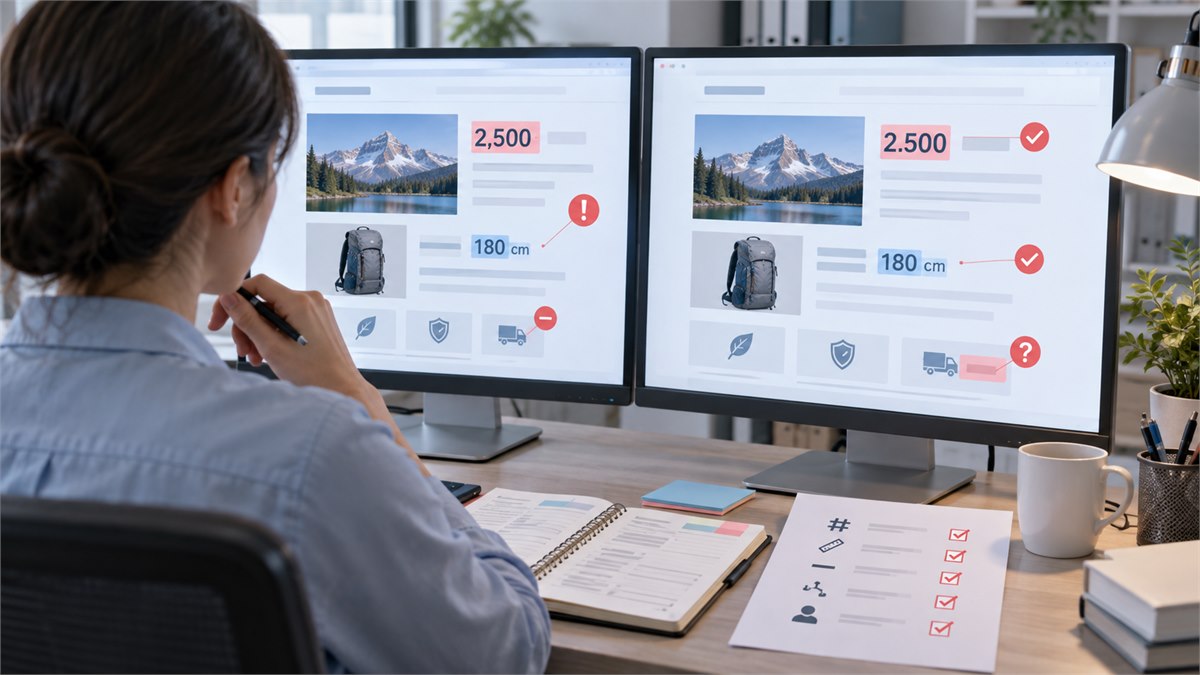
五、用“数字、否定、条件、名称”四类信息复核快速阅读可以接受先看机器翻译,但涉及合同条款、操作步骤、研究资料或采购信息时,应回到原文复核关键句。优先检查金额、日期、百分比和单位;再检查 not、unless、except 等否定或条件关系;最后核对人名、组织名、产品名和专业术语。
表格和列表还要检查行列对应关系。某个译文即使句子通顺,只要落在错误的表格单元格里,就可能改变结论。对准备公开发布、提交客户或用于重要决定的内容,应由具备相关语言与专业背景的人复核,自动翻译不应替代法律、医疗、金融等专业判断。
如果网页始终无法翻译,先记录操作系统、浏览器或客户端版本、页面地址、发生时间、源语言与目标语言,以及具体是“无法启动”“部分漏译”还是“排版错位”。截图时遮盖账号、订单号和其他无关个人信息,再通过联系支持页面查找公开反馈渠道。
翻译网页可能涉及页面正文、登录状态或主动选择的内容。处理工作资料前,应阅读相应服务的隐私说明,并遵守组织内部对商业秘密、客户资料和受限内容的规则。
网页翻译检查清单- 页面正文是否已经完整加载并展开?
- 是否选对源语言和目标语言?
- 漏译内容属于文本、图片、嵌入框架还是动态区域?
- 页面错位时是否改用划词、截图或文本翻译?
- 数字、单位、否定关系和专有名称是否回到原文复核?
- 是否避免提交无关的账号信息和敏感资料?
稳定的网页翻译流程应当是“先识别页面类型,再选择合适入口,最后回到原文核对重点”。这样既能提高阅读速度,也能避免把排版正常、语句流畅误当成内容一定准确。